Tento článek shrnuje zkušenost z více integračních projektů systému Vema do Identity Manageru IdStory. Zkušenosti pocházejí jak z mezinárodních holdingových společností, tak z organizací s tisíci zaměstnanci v jedné zemi. Popsané situace, problémy a řešení vycházejí z reálných nasazení v různých prostředích.
Výchozí stav
Představte si organizaci, která řeší správu identit ve větším měřítku. Může to být mezinárodní holding s desítkami dceřiných společností a regionálních pracovišť, nebo jediná organizace s tisíci zaměstnanci a několika pobočkami. V obou případech každý měsíc nastupují desítky až stovky nových kolegů, dochází k vnitřním přesunům a ukončení pracovních poměrů. Před zavedením IdM probíhala výměna informací mezi personálním a IT oddělením pomocí e-mailů, ticketů v service desku a tabulek. Tento způsob přinášel hned několik problémů. Vznikaly chyby v uživatelských jménech. Zaměstnanci zdlouhavě čekali na přístupy do systémů. A v neposlední řadě představovaly bezpečnostní riziko tzv. mrtvé účty, které zůstávaly v systémech i po odchodu zaměstnance. V naprosté většině případů se přístupy řeší primárně do MS Active Directory.
IT tým bývá zahlcen rutinní administrativou, zatímco organizace postrádá jednotný přehled o identitách. Nasazení Identity Manageru (IdM) IdStory a jeho napojení na personální systém Vema mění tento proces v plně automatizovaný, bezpečný a transparentní tok dat.
Kontext a cíle implementace
V kontextu napojení systému Vema do IdM se typicky jedná o následující cíle. Hlavním z nich je zprovoznit Vemu jako autoritativní zdroj pravdy v IdM pro veškeré interní zaměstnance a externí pracovníky (pokud jsem ve Vema evidováni) a navázat na ni automatizovaný provisioning do koncových systémů. Mezi další klíčové požadavky patří:
- Automatizace životního cyklu identit: Od vzniku pracovního poměru přes změny pozic až po okamžitý offboarding.
- Konsolidace více instancí: Sjednocení dat z různých poboček a dceřiných společností pod centrální správu.
- Ochrana osobních údajů: Zajištění souladu s bezpečnostními standardy při nakládání s citlivými identifikátory.
- Správa časových řezů: Schopnost systému reagovat na budoucí nástupy a historické změny úvazků.
- Univerzálnost nasazení: Pokrytí jak on-premise, tak cloudových instalací systému Vema.
Architektura řešení
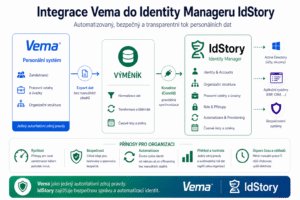
Architektonický návrh využívá model databázového výměníku, který zajišťuje izolaci personálního systému od IdM platformy a stabilitu synchronizací. Stejná architektura funguje pro on-premise i cloudovou Vemu, mění se pouze způsob, jakým exportní vrstva data získává.
- Exportní vrstva: Specializované Python skripty fungují jako most mezi zdrojem dat a výměníkem. U on-premise instalací čtou data z lokálního úložiště Vema, u cloudové Vemy se připojují přímo k cloudové instanci a stahují data odtud. Výsledek je v obou případech stejný: data v tabulkách výměníku v jednotném tvaru.
- Mezivrstva (Výměník): Relační databáze (MS SQL nebo PostgreSQL), ve které databázové view sjednocují formáty a transformují data z HR systému do podoby, kterou očekává IdM.
- Konektorová vrstva: IdM se připojuje k výměníku pomocí standardizovaného databázového rozhraní (ConnId Database Table konektor využívající JDBC), které zajišťuje pravidelné načítání identit, organizačních struktur a pracovních vztahů.
Implementace
Mapování dat z Vemy
Žádné dvě nasazení Vemy nejsou identická. Každá organizace má systém nakonfigurován podle svých interních pravidel a používá i různí tabulky, a proto před vlastní integrací provádíme analýzu zdrojových dat. Společně s personálním a IT oddělením zákazníka identifikujeme, kde jsou v konkrétní instanci uloženi zaměstnanci a externí pracovníci, kde jsou pracovní vztahy a úvazky a jak je modelována organizační struktura. Tento krok určuje, co bude exportní vrstva číst a jakým způsobem se data převedou do tabulek výměníku. Bez správného mapování by IdM dostával neúplná nebo zkreslená data a celá automatizace by stála na vratkém základu.
Podpora on-premise i cloudové Vemy
Řešení podporuje obě varianty nasazení Vemy. Pokud má část poboček on-premise a část v cloudu, oba zdroje se sbíhají do téhož výměníku a do IdM přicházejí jako jednotný datový tok.
V prostředích, kde organizace provozuje desítky dceřiných společností a desítky instancí Vemy, je výhodné, že zákazník si časem dokáže napojování dalších společností spravovat sám. První vlnu integrací realizujeme společně se zákazníkem. Postupně, jak si interní tým projde proces u několika společností, získává praktickou znalost mapování dat, konfigurace exportní vrstvy i logiky výměníku. Po několika společně odvedených napojeních je tým schopen rozšiřovat řešení o další společnosti vlastními silami. Tím se výrazně zkracuje doba potřebná k zařazení nově akvírovaných nebo nově vzniklých subjektů pod centrální správu identit a klesá závislost na dodavateli.
Logika hlavního úvazku
Klíčovým prvkem implementace je logika určování hlavního úvazku. V prostředích s více souběžnými smlouvami IdM automaticky vyhodnocuje prioritu úvazku na základě typu pracovního vztahu, funkčního zařazení nebo explicitních příznaků z HR systému. Tato logika řídí generování primárního loginu, e-mailové adresy, určuje organizační zařazení a přiřazená oprávnění v Active Directory.
Bezpečnost citlivých dat
Pro zajištění maximální bezpečnosti jsou citlivé osobní údaje uživatelů hashovány již při výstupu z HR systému. IdM tak pracuje pouze s unikátními otisky, které umožňují korelaci identit napříč systémy, aniž by docházelo k ukládání nešifrovaných citlivých dat v integrační vrstvě.
Problémy a jejich řešení
Při návrhu integrace bylo třeba proaktivně ošetřit několik typických rizik, která se v podobných projektech opakují. Bez jejich řešení by IdM v provozu narážel na situace, ve kterých by data nebyla konzistentní nebo by automatizace selhávala v okrajových případech.
Kolize identifikátorů
V multispolečnostním prostředí by docházelo k překryvům v číselných řadách organizačních útvarů, protože jednotlivé pobočky používají vlastní, na sobě nezávislé číslování. Stejný kód útvaru tak může existovat současně v několika společnostech a systém by je nedokázal jednoznačně odlišit.
Řešením je dynamické doplňování prefixů ke kódům organizačních jednotek. Každý útvar získá před svůj původní kód identifikátor konkrétní pobočky či společnosti, čímž je napříč celým prostředím zajištěna jednoznačnost. Výhodou tohoto přístupu je, že zákazník nemusí měnit zavedené číselné řady ve svých HR ani lokálních systémech. Prefixy se přidávají automaticky až v mezivrstvě.
Aktivace budoucích změn
Standardní přírůstková synchronizace kontraktů reaguje pouze na změny provedené v HR systému. Problém by ale nastal u zaměstnanců, jejichž nástup je v HR zaevidován s předstihem, například několik týdnů dopředu. HR systém v den reálného nástupu žádnou novou změnu neprovede, takže synchronizace by neměla co přenést a IdM by zaměstnance v den D automaticky neaktivoval. Nový kolega by tak první den v práci neměl přístupy do systémů.
Proto je v řešení od začátku zapojena funkce časových řezů pro kontrakty. IdM každý den nezávisle na událostech v HR projde všechny evidované časové řezy kontraktů, zkontroluje jejich aktuální platnost a přepočte kontrakty. Pokud má někdo k danému dni začít pracovat, systém to sám rozpozná a automaticky aktivuje jeho účty a přístupy. Stejný mechanismus spolehlivě zachytí i konce kontraktů, změny úvazků nebo dočasné pozastavení.
Správa logů
Provoz výměníku generuje velké množství databázových transakcí, protože synchronizace mezi HR systémem a IdM probíhá často a v plném rozsahu. Každá změna se zapisuje do transakčního logu databáze, který by bez správného nastavení rostl rychleji, než by se stíhal čistit. V krajním případě by zaplnění logu vedlo k zastavení databáze a tím i celé synchronizace identit.
Řešení spočívá ve dvou konfiguračních krocích. Databáze výměníku je provozována v takzvaném jednoduchém režimu obnovy (Simple recovery model), který automaticky uvolňuje místo v logu po dokončení každé transakce a nezadržuje celou historii změn. Ta pro mezivrstvu tohoto typu není potřeba, protože autoritativním zdrojem dat zůstává HR systém, nikoli výměník. Zároveň jsou nastaveny pevné limity pro maximální velikost logovacích souborů, což chrání databázi před neočekávaným nárůstem a usnadňuje kapacitní plánování.
Lessons learned
- Role výměníku: Mezivrstva je kritická pro stabilitu celého řešení. Umožňuje IdM IdStory provádět datové úpravy a čištění (ořezání mezer na začátku a konci hodnot) bez nutnosti zasahovat do nastavení personálního systému.
- UX pro správce: Automatické sestavení stromové struktury pracovišť v IdM na základě dat z Vemy výrazně zvyšuje přehlednost a usnadňuje administrátorům přidělování aplikačních rolí.
- Konzistence dat: Modelování kontraktů jako časových řezů v IdM je nezbytné pro správné fungování automatizovaného provisioningu do koncových systémů, zejména u dopředně plánovaných personálních změn.
- Samoobslužné rozšiřování: U organizací s desítkami instancí Vemy je provozně výhodné, když si interní tým zákazníka dokáže napojení dalších společností řešit sám. Tato schopnost přichází postupně. První napojení vedeme společně, zákazník si proces osvojí v praxi a po několika společně odvedených integracích se posouvá do role samostatného provozovatele.
Závěr
Integrace personálního systému Vema do Identity Manageru IdStory přinesla organizacím řád a automatizaci do správy uživatelských oprávnění. Odstranění manuálních přepisů dat zkrátilo proces nástupu zaměstnance z dnů na jednotky minut a garantuje okamžité blokování přístupů při odchodu.
Díky podpoře on-premise i cloudové Vemy a možnosti zákazníka samostatně rozšiřovat řešení o další společnosti je architektura připravena růst spolu s organizací. Digitální identita je nyní přesným odrazem reálného stavu organizace, což zvyšuje efektivitu práce IT oddělení i celkovou bezpečnost informačních systémů.